Thorsten Siefert
Technik und Gestaltung
Thorsten Siefert
Es gilt das gesprochene Wort
Coding Agents haben sich in erstaunlich kurzer Zeit von brauchbaren Assistenten zu Werkzeugen entwickelt, die umfangreiche Entwicklungsaufgaben über längere Strecken selbstständig bearbeiten können.
Das bedeutet aber nicht, dass Qualitätskontrollen überflüssig werden. Im Gegenteil: Wenn die eigentliche Codeproduktion immer billiger und schneller wird, verlagert sich die Verantwortung auf Anforderungen, Architekturentscheidungen, automatisierte Nachweise und die Frage, wer am Ende bewusst die Verantwortung für das Ergebnis übernimmt.
Die Schranken beginnen zu fallen
Robert C. Martin – „Uncle Bob“ –, der durch seine Bücher „Clean Code“ und „Clean Architecture“ die Industrie maßgeblich geprägt hat, hat am 12. September etwas geschrieben, das ich wirklich bemerkenswert finde.
Er hatte mehrere Wochen daran gearbeitet, Coding Agents in ein relativ enges Korsett aus Prozessen, Gates, Tests und Werkzeugen zu zwingen. Während er diesen Harness perfektionierte, wurden die Modelle allerdings so viel besser, dass er sich anschließend fragte, ob er sie inzwischen schlicht überreguliert.
Unit Tests hält er weiterhin für wichtig. Ebenso CRAP-Metriken und Mutation Testing. Aber seine Erfahrung ist inzwischen offenbar eine andere: Einem Agenten eine größere Aufgabe mit einigen Leitplanken geben, weggehen und vierzig Minuten später brauchbaren, getesteten und architektonisch sauberen Code vorfinden.
Das Interessante daran ist für mich weniger die konkrete Leistungsbehauptung.
Interessant ist, was sich damit an unserer Vorstellung von Softwarequalität verändert.
Ich kenne dieses Gefühl
Mir geht es inzwischen ähnlich.
Ich habe in meinen Projekten zunächst ziemlich viele Schranken aufgebaut: Repository-Regeln, explizite Arbeitsabläufe, Architekturvorgaben, Tests, Build-Prüfungen und Dokumentationspflichten.
Das war alles andere als unbegründet. Noch vor relativ kurzer Zeit musste man Agents sehr genau führen, damit sie nicht nach fünf Änderungen drei neue Baustellen aufmachten.
Aber ich ertappe mich zunehmend dabei, solche Vorgaben wieder abzubauen.
Nicht, weil mir Qualität plötzlich weniger wichtig wäre.
Sondern weil eine gute Coding AI heute teilweise wirklich besser arbeitet, wenn ich ihr das Problem, die vorhandene Architektur und das gewünschte Ergebnis erkläre und ihr dann genügend Raum lasse, eine Lösung zu entwickeln.
Interessanterweise beschreibt auch OpenAI genau diese Entwicklung aus einer anderen Richtung. In einem 2026 veröffentlichten Bericht über ein agentengetriebenes Softwareprojekt entstand nach eigenen Angaben rund eine Million Zeilen Code ohne manuell geschriebenen Anwendungscode. Entscheidend waren dabei aber keineswegs fehlende Regeln: Das Team verlagerte seine Arbeit auf Repository-Wissen, maschinenlesbare Vorgaben, Feedback-Loops und überprüfbare Systemgrenzen. Ein riesiges AGENTS.md erwies sich sogar als kontraproduktiv; stattdessen wurde eine kurze Orientierung mit strukturierten Dokumenten als „System of Record“ aufgebaut.
Das ist ein wichtiger Unterschied.
Weniger Mikromanagement ist nicht dasselbe wie weniger Governance.
„Alle Tests grün“ ist noch keine Codequalität
Gerade Coding Agents führen zu einer interessanten Versuchung.
Der Agent liefert Code. Die Unit Tests laufen. Die Code Coverage liegt bei 95 Prozent. Static Analysis ist zufrieden. Vielleicht läuft sogar Mutation Testing durch.
Also: fertig?
Nicht unbedingt.
Code Coverage sagt zunächst nur, welcher Code während eines Tests ausgeführt wurde. Mutation Testing geht erheblich weiter: Dabei werden gezielt kleine Fehler in den Code eingebaut und geprüft, ob die Tests diese Veränderungen erkennen. Damit lässt sich wesentlich besser beurteilen, ob eine Testsuite tatsächlich Fehler entdeckt und nicht lediglich Code ausführt.
Auch der CRAP-Index kombiniert deshalb Testabdeckung mit zyklomatischer Komplexität. Die Grundidee: Komplexer Code ohne vernünftige Tests ist besonders riskant zu warten.
All das sind nützliche Signale.
Aber kein einzelnes davon beantwortet beispielsweise die Fragen:
Hat der Agent überhaupt das richtige Problem gelöst?
Passt die Lösung langfristig zur Architektur?
Hat er eine Sicherheitsannahme verändert?
Hat er bestehende Nebenbedingungen verstanden?
Ist die Entscheidung auch in sechs Monaten noch nachvollziehbar?
Und, gerade in regulierten Umgebungen wichtig, können wir erklären, warum das System heute so aussieht, wie es aussieht?
Deshalb werden Architecture Decision Records (ADRs) wichtiger, nicht unwichtiger
An dieser Stelle bekommen ADRs für mich eine neue Bedeutung.
Ein ADR dokumentiert nicht einfach, was entwickelt wurde. Es hält eine architektonisch relevante Entscheidung mitsamt Kontext, Alternativen, Begründung und Konsequenzen fest. Genau diese Entscheidungslogik ist der Teil einer Softwarearchitektur, der sich aus dem fertigen Quellcode häufig kaum noch rekonstruieren lässt.
Wenn wir ehrlich sind, war das schon bei menschlich entwickelter Software ein Problem.
Bei AI-gestützter Entwicklung wird es wichtiger.
Denn ein Agent kann in wenigen Minuten eine erstaunlich plausible Lösung erzeugen. Wenn wir anschließend nur den Code speichern, aber nicht die dahinterliegende Entscheidung, verschwindet das Wissen mit dem Kontextfenster der Session.
Mein bevorzugtes Modell lautet deshalb zunehmend:
Der Agent darf Lösungsspielraum bekommen. Architekturentscheidungen müssen dagegen explizit werden.
Das ist für mich eine sinnvollere Schranke als hundert kleinteilige Prompt-Regeln.
ADRs sind damit nicht nur Architekturdokumentation. Sie werden zu einer Schnittstelle zwischen menschlicher Verantwortung und maschineller Umsetzung.
Und dann schaut der Computer eben in den Spiegel.
Wie weit sich diese Arbeitsweise treiben lässt, zeigt gerade ein herrlich absurdes Beispiel aus dem Omarchy-Umfeld.
Justin Schroeder zeigte in einem Post ein MacBook, auf dem an der Unterstützung externer Displays mit AMD-Radeon-Grafik gearbeitet wurde. Der Rechner beobachtete dabei sein eigenes Display – über die Webcam und einen Spiegel.
Der Grund ist technisch durchaus nachvollziehbar: Ein normaler Screenshot kann korrekt aussehen, obwohl ein Fehler erst später in der tatsächlichen Display-Pipeline entsteht. Die Kamera sieht dagegen am Ende des Weges das, was auf dem physischen Bildschirm tatsächlich erscheint. Das ergibt einen Feedback-Loop vom Code bis zu den realen Photonen vor dem Display.
Das ist gleichzeitig genial und ziemlich verrückt.
Und vielleicht ein wunderbares Bild dafür, wo wir uns gerade befinden.
Hypothese aufstellen. Code ändern. Maschine neu konfigurieren. Ergebnis physisch beobachten. Nächste Iteration.
Man könnte es – etwas zugespitzt – den YOLO-Modus der Softwareentwicklung nennen.
Für Forschung, Prototyping und eine private Entwicklungsmaschine finde ich das faszinierend.
Für ein produktives System eines regulierten Unternehmens würde ich daraus noch kein Betriebsmodell ableiten wollen.
Das Problem ist nicht mehr primär das Schreiben von Code
Genau darin liegt meines Erachtens die entscheidende Verschiebung.
Lange Zeit war Quellcode ein knappes Gut. Änderungen waren teuer. Deshalb steckte ein großer Teil der Qualitätssicherung zwangsläufig im Entwicklungsprozess selbst.
Wenn ein Agent dagegen innerhalb einer Stunde Änderungen erzeugen kann, für die ein Entwickler früher Tage benötigt hätte, wird Code billig – Veränderung aber nicht.
Die Datenmigration kann immer noch Daten zerstören.
Die API kann immer noch einen Vertrag mit anderen Systemen brechen.
Eine falsche Autorisierungsentscheidung bleibt falsch.
Eine architektonische Abkürzung erzeugt weiterhin technische Schulden.
Und 10.000 automatisch erzeugte Zeilen schlechten Codes sind nicht besser, nur weil ihre Entstehung praktisch nichts gekostet hat.
Hinzu kommt die Security-Perspektive. Untersuchungen zu LLM-generiertem Code finden weiterhin relevante Schwachstellen; in einer 2025 veröffentlichten Untersuchung enthielten 275 von 600 generierten JavaScript-Beispielen mindestens eine Schwachstelle. Solche Laborergebnisse lassen sich nicht eins zu eins auf moderne agentische Entwicklungsumgebungen übertragen, zeigen aber, warum funktionierende Software und sichere Software zwei unterschiedliche Qualitätsmerkmale bleiben.
Meine Schranken werden deshalb weniger – aber anders
Ich halte es inzwischen für sinnvoll, zwischen zwei Arten von Schranken zu unterscheiden.
Die erste versucht, dem Agenten jeden einzelnen Arbeitsschritt vorzuschreiben. Diese Art von Harness kann mit besseren Modellen tatsächlich schnell zur Behinderung werden.
Die zweite definiert überprüfbare Eigenschaften des Ergebnisses.
Dazu gehören für mich heute insbesondere:
- reproduzierbarer Build und klar begrenzte Änderungen,
- Unit-, Integrations- und gegebenenfalls End-to-End-Tests,
- Mutation Testing dort, wo Fehlerfolgen relevant sind,
- Static Analysis, Dependency- und Security-Prüfungen,
- dokumentierte Architekturentscheidungen,
- nachvollziehbarer Git-Verlauf und einfacher Rollback,
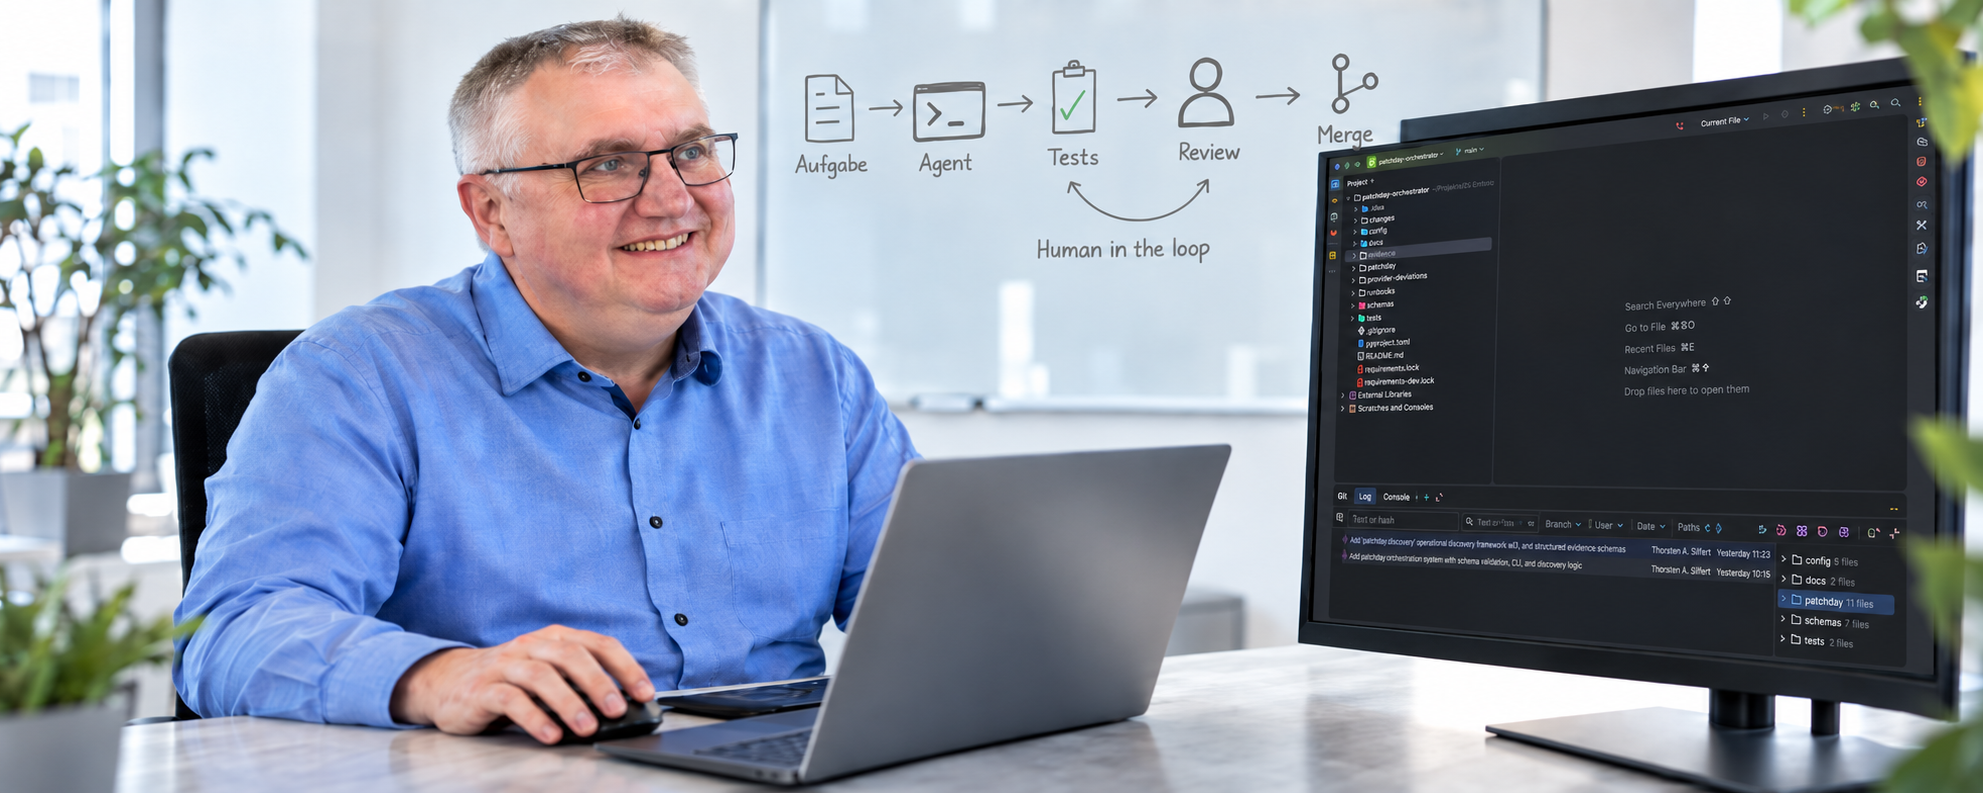
- und vor der Übernahme in ein produktives System ein verantwortliches menschliches Review.
Auch Anthropic empfiehlt für agentisches Coding klare überprüfbare Ziele, testgetriebene Schleifen und bei Bedarf eine Trennung zwischen erzeugendem und prüfendem Agenten. Das Entscheidende daran ist für mich das Prinzip: Nicht den Denkweg vollständig vorschreiben, sondern ein Umfeld schaffen, in dem Fehler sichtbar werden.
Das dürfte langlebiger sein als ein ausgefeiltes Prompt-Regelwerk.
Wer trägt die Verantwortung für den Merge?
Damit landen wir bei einer Frage, die technisch klingt, letztlich aber Governance ist.
Wenn ein Coding Agent einen Pull Request erzeugt, wer erklärt anschließend:
Ja. Diese Änderung wollen wir in unserem System haben.
Momentan lautet meine Antwort darauf weiterhin: ein Mensch.
Das muss nicht zwangsläufig für immer so bleiben. Schon heute wird diskutiert, wie weit agentische Reviews menschliche Code Reviews ersetzen oder ergänzen können. Die Forschung ist dabei keineswegs eindeutig: Neuere Arbeiten sehen erhebliche Effizienzpotenziale, aber noch keinen automatischen Gewinn bei der Review-Qualität.
Deshalb würde ich für produktive Systeme derzeit nicht auf das persönliche Review verzichten.
Nicht aus Nostalgie.
Sondern weil Verantwortung etwas anderes ist als Fehlererkennung.
Mein Zwischenstand
Die vergangenen Monate haben meine Haltung zur AI-gestützten Softwareentwicklung verändert.
Ich vertraue guten Coding Agents inzwischen deutlich mehr Freiheit an als noch zu Jahresbeginn. Manche der Schranken, die ich gebaut habe, wirken tatsächlich schon wieder wie Relikte einer früheren Modellgeneration.
Tests verschwinden dadurch nicht.
Architektur verschwindet nicht.
Dokumentation verschwindet nicht.
Und Verantwortung verschwindet schon gar nicht.
Sie verlagert sich.
Mein persönlicher Stand heute ist deshalb ziemlich einfach:
Ich fange langsam an, die „Schranken“ abzurüsten, auch wenn sich das noch sehr ungewohnt anfühlt. Ganz ohne persönliches Review geht bei mir trotzdem keine Codezeile durch.
Aber: Vielleicht spricht da aber auch einfach der Compliance-Guy in mir. 😄